はじめに
2026年1月、プロダクトマネージャーとしてTalentXに入社したhiromotoです。当社は「MyTalent Platform」という形で複数プロダクト(MyTalent Hire、MyTalent CRM、MyTalent Refer(MyRefer)、MyTalent Brand)が連携しており、PMもプロダクトを横断して要件定義を進めています。意思決定は可能な限り一次情報とデータに基づいて行う、というのが当社の基本姿勢です。
ところが入社当初は、ドメイン知識もプロダクト理解も浅く、判断の根拠となるデータを抽出するのが難しい状態でした。複数プロダクトが横断で連携しているため、そのデータがどのプロダクトの持ち物なのかが把握しづらい状況でした。
そのような状況下で、自分でSQLを書いて抽出しようにも、テーブル同士の繋がりが見えにくく、苦戦することも多くありました。
要件定義も同様で、要件をまとめきったと思ったら、実は他のプロダクトとも連携する仕様だったと分かり練り直しになることが多々あり、その都度整理し直すといった具合でした。 これらの悩みを、DevinやGeminiを使って解決しようと試みるも、なかなかうまくいきませんでした。
実際、チャットベースでのやり取りでは、都度一から説明し直す必要があり、数ヶ月ほど続けるうちに限界を感じるようになりました。つまり、AIの出力品質が「対話者(自分)の説明力」や「自分の理解度」に依存してしまっていたのです。だったら、繰り返し使う知識や型を「Skill」としてAI側に持たせてしまえばいい。そう考えて、要件定義とデータ分析、2つの業務をClaude CodeでSkill化してみました。
1: 要件定義Skillは「解決策を書かせない」
個人的にAIと壁打ちしながらPRDを作る中で、質がばらつくことを課題に感じていました。原因を辿ると、テンプレートはあっても、良い型を運用するノウハウは自分の頭の中だけにあり、それも忙しさや案件の相性で簡単に崩れてしまうことに気づきました。そこで要件定義Skillでは、まず「型」そのものをAIに持たせることから始めました。海外のPMが実践している要件定義の型をAIと一緒に調べ、要件定義には、「形式選択 → 問題フレーミング → 調査 → 執筆 → セルフレビュー」という5フェーズの型を持たせることにしました。
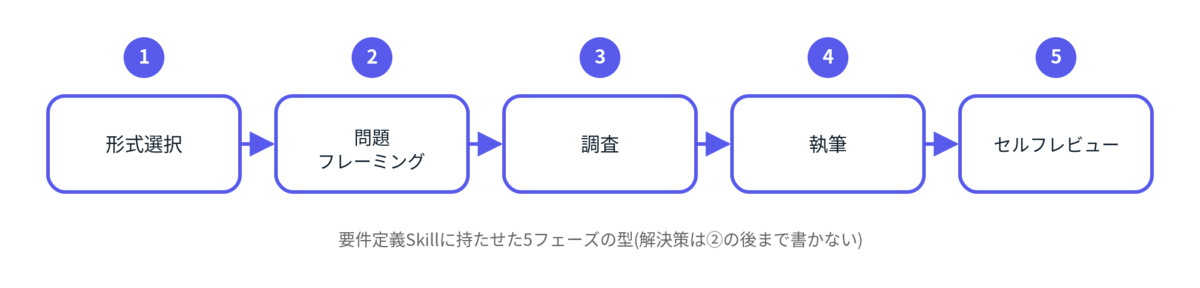
特に効果を感じたのは、解決策を書く前に「誰が」「どんな場面で」「何に困っていて」「放っておくとどうなるか」「なぜ今か」だけを固めるフェーズです。ここを飛ばして解決策から書き始めてしまう癖が自分にはありましたが、Skillが毎回「まだ解決策は書かないでください」と引き戻してくれます。
「調査」フェーズでは、既存のコードを読み取り、同様の機能がすでにあるか、プロダクト間の依存関係を可能な限り洗い出すようにしました。コードを読み込んでも依存関係をすべて網羅できるわけではなく、うまくいかないこともありますが、その都度Skillを更新して精度を上げています。
Skill化した後に変わったのは、案件ごとに「うちのPRDはこういう型で書いてほしい」と説明し直さなくてよくなったことです。また、依存関係や既存機能との関連性を把握した上でPRDを作成できるようになりました。型がAI側に残っている分、自分は問題の中身と取捨選択に時間を割くことに集中でき、手戻り回数や考慮もれも、体感としては減ってきました。
2: データ分析Skill(コードを読ませてDB辞書を作り、SQLを生成させる)
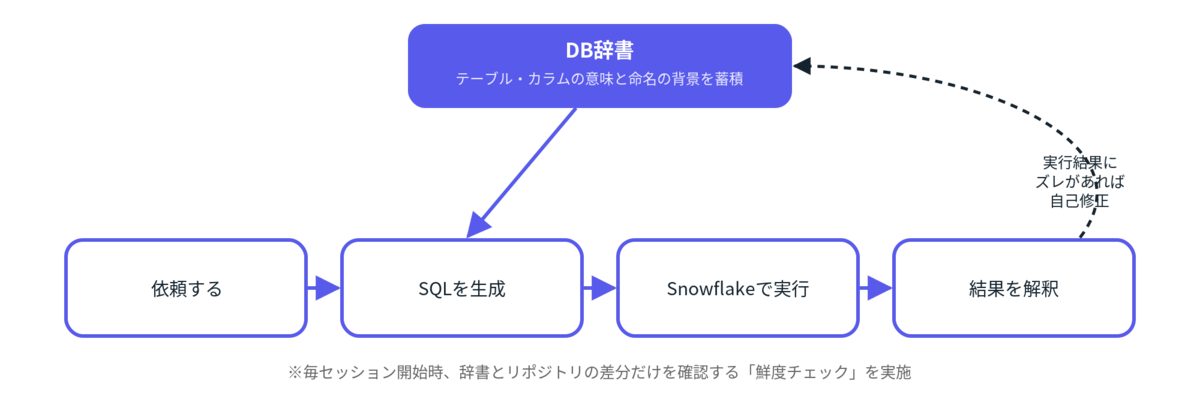
データ分析の方は、いきなりSQLを書かせるところから始めませんでした。まず、社内向けに配布されているClaude Codeに、権限の範囲内でMyTalent Platformの主要なコードを読ませて、テーブルやカラムの意味、命名の背景をまとめた「DB辞書」を作らせるところから始めました。入社半年の自分がまだ掴みきれていなかった「そもそも何がどこにあるか」を、AI経由で先に埋めてしまう、というやり方です。
この辞書がSkillの土台にあることで、その後のSQL生成の精度とスピードが変わりました。分析したいことをAIに伝えると、辞書を踏まえた上でSQLを生成してくれます。ただし辞書はあくまで静的なスナップショットで、元のGitHubリポジトリには日々変更がコミットされているため、辞書にまだ反映されていない新しいマイグレーションが積み重なっていきます。そこで、ローカル環境のリポジトリのコピーを夜間に自動的に最新化し、その上で、データ抽出セッションでSQLを生成する前に必ずSkillとローカルレポジトリの差分をチェックし、辞書より新しい変更があればその部分だけを読んでAIが回答する仕組みにしました。実際にSnowflakeで実行した結果、辞書とズレがあると分かった場合、差分を自身でレビューし、気になる変更があれば都度Skillをアップデートします。
その結果、都度スキーマを説明する必要がなくなり、テーブル間の関係を毎回自分が把握していなくても、まず動くSQLの叩き台が出てきます。ただし、SQLをそのまま使うわけではなく、結合条件や抽出カラム、集計条件を確認してから使うようにしています。実際の運用は、依頼する→Skillがコンテキストを踏まえてSQLを生成する→自分がSnowflakeで実行する→結果を解釈する、という役割分担です。
例えば、外部の求人媒体との連携PJでは、項目マッピングをする際に、既存データが連携先の必須項目にどこまで対応できるかを確認する必要がありました。そのため、企業×求人×分類マスタという複数テーブルを跨いで突き合わせを行い、マッピング表を作成していきました。以前ならその都度必要データをエンジニアに依頼していた内容です。今はSkillが生成したSQLを自分で実行し、精査結果をもとに追加で必要なデータがあればSkillを使ってすぐに抽出できるようになりました。
作業を進める中で、あるコード値の意味が辞書に載っていない場面もありましたが、Skillが推測で埋めずに「確認用のSQLを実行してほしい」と教えてくれたので、誤った前提のまま進めずに済みました。
2つの事例から見えた「良いSkillの条件」
性質の違うこの2つの業務をSkill化してみて見えてきたのは、社内の用語やテーブル定義、過去の意思決定の型といったドメイン知識を固定化するほど効果が出る、ということです。逆に言えば、Skillはあくまで「型」であり、最終的な判断は人間に残ります。「ここは人間が決めてください」という箇所を明示する仕組みがあると、Skillに任せていい部分と自分で決めるべき部分の境界がはっきりし、そこに人間のチェックが入る分、誤った成果物がそのまま利用されるリスクを軽減できます。
うまくいかなかった点
要件定義・データ抽出をSkillで行うようになってから、スピードは向上した一方で、個々の理解が『点』にとどまり、プロダクト全体を『線』で捉える力が弱くなる感覚があります。原因は、Skillが自動でコンテキストを埋めてくれる分、自分の手で既存コードが実装された背景を追ったりテーブルを辿ったりする「調べる」作業そのものが減ったことにあると思います。以前はその調査の過程で自然と繋がりが見えていましたが、今はSkillの中で完結してしまう分、繋がりを見る機会自体が減っています。AIに頼るほど、Skillが増えるほど、この「線を引く」作業は自分の仕事として重みを増しています。
今の立ち位置と、この先
今回、要件定義とデータ分析をSkill化してみましたが、AI活用としてはまだ入り口の段階だと感じています。それでも、このPMの定型業務を型化したことで、効率と質が変化したのを感じています。ただ、便利になった分だけ自分の役割が減るわけではなく、より広範囲の業務や上位の意思決定も合わせて必要になってきた、というのが今のところの実感です。
上位の意思決定ほど、点在する情報を線で繋いで見る力が求められます。そのため、全てをAIに頼るのではなく、AIが仕上げた結果を一次データと突き合わせてレビューする時間をきちんと確保し、その力を養っていきたいと考えています。Skillに任せて浮いた時間の一部は、この確認作業に自分の手を動かすことに充て、頭の中の繋がりを構築していくつもりです。
今はPM業務の一部をSkill化しているだけですが、その実践を通じて効率化を重ね、最終的にはヒアリング結果をもとにプロトタイプを自動作成するといった、職域を超えた領域までSkill化の対象を広げていきたいです。
さいごに
現在、TalentXではPMやエンジニアの仲間を募集しております。プロダクト横断で開発・意思決定に関わりたい方は、ぜひご応募ください。
TalentX採用ページ talentx.brandmedia.i-myrefer.jp
カジュアル面談 i-myrefer.jp
